# RFC GVA \> movementsByPubkey() et \`time\` redressé
**URL:** https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344
**Category:** GVA
**Tags:** gva, graphql
**Created:** [26 July 2019 14:50 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344 "2019-07-26T14:50:21Z")
**Posts on this page:** 17
**Page:** 1
### Author:  [@kimamila](https://forum.duniter.org/u/kimamila)
#### Post date: [26 July 2019 14:50 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/1 "2019-07-26T14:50:21Z")
En regadant de plus près la [RFC GVA](https://git.duniter.org/nodes/common/doc/blob/graphql_api_rfc/rfc/0003%20RFC%20GraphQL%20API%20for%20Duniter%20Clients.md#graphql-verification-api-aka-gva) et le schema proposé par @elois, je me pose plusieurs questions :
- Comment récupérer simplement la liste des TX d’un utilisateur ?
- Dans `Transaction` je ne vois pas la date du bloc, mais seulement `BlockNumberAndHash`. Comme déjà dit, cela necessite donc de refaire une requete pour avoir le `time` ou `medianTime` du block, et ainsi afficher l’heure.
- Dans le type `Transaction`, qu’est que `Type: String!` (cf [ici](https://git.duniter.org/nodes/common/doc/blob/graphql_api_rfc/appendices/0003_RFC/schema.gql#L318))? est-ce pour T=Tx et D=UD ?
- Puis-je renommer `BlockNumberAndHash` en `BlockStamp` (ou `BlockRef` ou BlockId) ?
---
### Author:  [@elois](https://forum.duniter.org/u/elois)
#### Post date: [26 July 2019 18:56 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/2 "2019-07-26T18:56:35Z")
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/63):
>
> Comment récupérer simplement la liste des TX d’un utilisateur ?
Grâce a l’input issuer de la requête transactions :
```
transactions(
paging: Paging!
issuer: String
state: DocumentState!
): Transactions
```
`issuer` est la clé publique en base58, ça te renverra toutes les tx qui ont cette clé publique dans leurs issuers.
L’input `state` te permet de choisir entre les tx inscrites en blockchain ou les tx en piscine, ou les deux 🙂
La pagination est obligatoire avant d’éviter les abus et de limiter la surface d’attaque.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/63):
>
> Que pensez vous de faire une entrée : `movementsByPubkey(pubkey): [Movement!]!`
> Le type Movement pourrait avoir le minimum requis, sans tous les outputs, inputs, etc.
Je trouve qu’il y a déjà le minimum requis dans l’entrée transactions cités ci-dessus. La clé publique, la pagination, et l’état (écris, en piscine, ou tout).
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/63):
>
> Autre possibilité : ajouter un champ calculé `amount` au type `Transaction` . Je penses que ce serait plus dur à identifier pour un néophyte, parmi tous les champs déjà existants…
Oui pourquoi pas 🙂
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/63):
>
> Dans `Transaction` je ne vois pas la date du bloc, mais seulement `BlockNumberAndHash` . Comme déjà dit, cela necessite donc de refaire une requete pour avoir le `time` ou `medianTime` du block, et ainsi afficher l’heure.
>
> - Je penses donc ajouter le champs `time: Int!` qui sera le temps le plus proche de la réalité (Celui que calcule Cesium) = medianTime + (avgGenTime \* medianTimeBlocks / 2).
> Ainsi les clients auront directement tout ce qu’il faut. Qu’en pensez vous ? (cc @vtexier et @cgeek)
Que c’est dommage d’utiliser Int!, ça fait du typage très faible. Dans ce cas merci d’ajouter un type Timestamp :
```
type Timestamp {
timestamp: Int!
}
```
Aussi pour limiter les calculs coté serveur je préfère que les serveurs blockchain ne renvoient que le mediantTime. Chaque client étant libre dans sa façon de calculer ce qu’il considère être un temps “proche de la réalité” a partir du temps blockchain commun.
Je ne suit vraiment pas convaincu de la pertinence de cette formule.
De plus, les serveurs blockchain doivent faire référence dans les données qu’ils fournissent quel que soit “l’école” des uns et des autres.
Il y a un temps blockchain commun, c’est ce temps blockchain commun que doivent fournir les serveurs blockchain, c’est lui qui fait foi.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/63):
>
> Dans le type `Transaction` , qu’est que `Type: String!` (cf [ici](https://git.duniter.org/nodes/common/doc/blob/graphql_api_rfc/appendices/0003_RFC/schema.gql#L318))? est-ce pour T=Tx et D=UD ?
Oups c’est une erreur 😅, Ce champ n’existe pas, il faut le supprimer du schéma. Les transactions sont forcémetn des TX. Les UD ne sont pas des transactions 😉
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/63):
>
> Puis-je renommer `BlockNumberAndHash` en `BlockStamp` (ou `BlockRef` ou BlockId) ?
En Blockstamp qui est le terme utilisé partout dans le code des serveurs blockchain oui 🙂
Je déconseille BlockId car ce terme est parfois utilisé pour désigner le numéro du bloc.
@kimamila peut tu stp soumettre tes modif du schéma sur une branche tierce avec une demande de MR sur la branche de la rfc ? Je la relirai avec attention, merci beaucoup 🙂
---
### Author:  [@kimamila](https://forum.duniter.org/u/kimamila)
#### Post date: [27 July 2019 08:54 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/3 "2019-07-27T08:54:02Z")
Merci @elois pour ton retour, nous ne nous sommes pas compris, a propos du type Mouvement et de la récupération des transactions d’un compte. Je parlais du besoin pour l’utilisateur d’avoir le montant qui le concerne (celui qui est dans Mes opérations sous Césium) et évite de devoir le recalculer a chaque fois.
Pour le time calculé, si tu n’es pas persuadé de son utilité, je invite a te demander quelle heure est utilisé partout dans Césium.
Quel est le temps qu’attends les utilisateurs finaux ?
En l’etat de nos discussions, si GVA est bien destiné aux clients, je crois qu’il faut nous faire confiance aussi 🙂 ce que je lis de toi montre des réflexes d’une API inter-noeuds, comme WS2P. Or ce n’est pas l’objet. On veut un truc qui facilité la vie des développeurs de clients.
L’exemple du montant et de l’heure est typique.
Juste pour avoir la liste des mouvements d’un compte, il faudrait selon toi être expert dans le protocole DUP, récupérer les paramètres de la BC,
pour calculer l’heure réelle, savoir analyser les inputs et output des TX, etc.
Aucun intérêt selon moi : c’est comme utiliser BMA… Je l’ai fait et crois moi c’est énorme le code coté client pour faire tout ça !
---
### Author:  [@elois](https://forum.duniter.org/u/elois)
#### Post date: [28 July 2019 11:27 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/4 "2019-07-28T11:27:54Z")
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/67):
>
> Je parlais du besoin pour l’utilisateur d’avoir le montant qui le concerne (celui qui est dans Mes opérations sous Césium) et évite de devoir le recalculer a chaque fois.
@kimamila peut tu être plus précis sur le besoin stp ?
S’il s’agit d’avoir le solde du compte il suffit de récupérer toute les sources de la pubkey et de sommer leurs montants. Du coup je ne voit pas l’intérêt de ta proposition dans ce cas précis.
S’il s’agit de récupérer l’historique des transactions qui concernent un compte (entrantes comme sortantes), alors en effet rien ne le permet dans le schéma actuel. Dans ce cas on peut rajouter une requêtes `movementsByAccount` (pourquoi se limiter a une pubkey, ce n’est qu’un sous-ensemble des comptes possibles).
Avec comme inputs :
```auto
movementsByAccount(
paging: Paging!
# pubkey or script
account: String
state: DocumentState!
): Transactions
```
Ce qui retournerai le tableau des transactions concernant ce compte sur la période souhaitée (possible via l’input paging).
Concernant l’input account se pourrai être une clé publique ou un script de conditions plus complexes.
Cela répondrais t’il a t’on besoin ?
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/64):
>
> @elois, @vtexier avez vous commencez l’implémentation de GVA ?
De mon coté je n’ai aps encore commencé l’implémentation de GVA a proprement parlé mais je commence a architecturer le projet pour avoir un module client indexer qui indexera les données que GVA (ou tout autre API client) devra être capable de retourner.
J’ai besoin d’avoir le schéma complet et définitif avant de commencer car en fonction du schéma la façon d’architecturer pour pouvoir répondre de façon optimisée ne sera pas la même.
De pl,s conformément a la roadmap de Durs présenté aux dernières RML, l’api client sera développée début 2020, ont a d’autres chantiers plus prioritaires avant dans le projet Durs.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/67):
>
> Pour le time calculé, si tu n’es pas persuadé de son utilité, je invite a te demander quelle heure est utilisé partout dans Césium.
> Quel est le temps qu’attends les utilisateurs finaux ?
La question n’est pas la. Plus tu déplace de l’intelligence coté serveur plus tu fragilise les serveurs et donc la monnaie. Tout ce qui peut être délégué aux clients doit l’être.
De plus, il peut y avoir d’autres formules pour calculer un soi-disant " temps proche de réel", les serveurs blockchain doivent être neutres et ne pas imposée une interprétation particulière du temps blockchain commun.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/67):
>
> Quel est le temps qu’attends les utilisateurs finaux ?
Cela dépend des utilisateurs finaux de chaque clients. Ce n’est pas aux serveurs blockchain d’'en décider.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/67):
>
> si GVA est bien destiné aux clients, je crois qu’il faut nous faire confiance aussi 🙂 ce que je lis de toi montre des réflexes d’une API inter-noeuds, comme WS2P. Or ce n’est pas l’objet. On veut un truc qui facilité la vie des développeurs de clients.
Je suis d’accord pour faire mieux que BMA et fournir des données plus pratiques a exploiter, cependant il faut que j’en comprenne le besoin et la pertinence (comme pour l’historique des mouvements d’un compte pour lequel je t’ai fait une proposition).
Cependant je ne veut pas non plus que GVA devienne une usine a gaz déplaçant trop d’intelligence et de traitements coté serveurs blockchains, c’est dangereux et ça fragilise la monnaie.
De plus, les serveurs blockchain doivent autant que possible être neutre dans la façon d’interpréter les données. La formule de transformation du temps blockchain commun utilisée par Cesium ne me parle pas et n’est pour moi qu’une interprétation de se temps blockchain commun parmi d’autres.
De plus, c’est un traitement facile a faire coté clients.
Autant pour l’historique des mouvements d’un compte je comprend tout a fait après réflexion, autant pour le temps ça ne passe pas.
Prenons le temps d’en discuter point par point, de mesurer l’impact de chaque décision technique concernant cette API GVA. Le but c’est de faire ça bien sinon autant garder BMA.
Donc il faut prendre le temps d’expliciter chaque besoin et d’argumenter chaque solution proposée 🙂
---
### Author:  [@kimamila](https://forum.duniter.org/u/kimamila)
#### Post date: [29 July 2019 07:34 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/5 "2019-07-29T07:34:22Z")
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/68):
>
> @kimamila peut tu être plus précis sur le besoin stp ?
>
> S’il s’agit d’avoir le solde du compte il suffit de récupérer toute les sources de la pubkey et de sommer leurs montants. Du coup je ne voit pas l’intérêt de ta proposition dans ce cas précis.
C’est très simple : ouvre “Mes opérations” dans Cesium et demandes toi comment sont reconstituées toutes les informations affichées :
- le montant du mouvement (et non pas le montant de la transaction, car une transactions peut concerné plusieurs comptes destination")
- le ou les émetteurs / destinataires. il faut penser à exclure les outputs qui concerne les montant non consommé (la monnaie rendue).
- l’heure utilisateur de l’opération
Tout ceci est impossible a avoir directement, tel que tu as modéliser le type Transaction. Il faut bidouiller chaque TX recu, et récupérer tout plein d’info (inputs, outputs) qui ne vont servir que pour calculer ces champs.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/68):
>
> S’il s’agit de récupérer l’historique des transactions qui concernent un compte (entrantes comme sortantes), alors en effet rien ne le permet dans le schéma actuel.
Voila, c’est cela que je disais. 🙂
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/68):
>
> Dans ce cas on peut rajouter une requêtes `movementsByAccount` (pourquoi se limiter a une pubkey, ce n’est qu’un sous-ensemble des comptes possibles).
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/68):
>
> Ce qui retournerai le tableau des transactions concernant ce compte sur la période souhaitée (possible via l’input paging).
> Concernant l’input account se pourrai être une clé publique ou un script de conditions plus complexes.
> Cela répondrais t’il a t’on besoin ?
Oui, tout à fait. En revanche je ne trouve pas le nom du paramètre “account” très intuitif… a voir.
Peut-être plutôt :
```auto
movementsByPubkey(
paging: Paging!
pubkey: String
state: DocumentState!
): Transactions
movementsByCondition(
paging: Paging!
condition: String
state: DocumentState!
): Transactions
```
En principe, le développeur du client sait dans cas de figure il se trouve. Il peut aussi requeter les deux en une seule fois, via une requete multiple.
Coté noeud, ca permettra d’avoir des caches plus optimisé, par pubkey ou par condition, car les usages ne sont pas les même, et l’indexation sera différente.
Par exemple, il est légitime que movementsByPubkey retourne aussi les TX dont les conditions utilisent la `pubkey` (comme un `like` en BDD) et non pas seulement `=SIG(pubkey)`.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/68):
>
> La question n’est pas la. Plus tu déplace de l’intelligence coté serveur plus tu fragilise les serveurs et donc la monnaie. Tout ce qui peut être délégué aux clients doit l’être.
> De plus, il peut y avoir d’autres formules pour calculer un soi-disant " temps proche de réel", les serveurs blockchain doivent être neutres et ne pas imposée une interprétation particulière du temps blockchain commun.
Nous ne sommes pas d’accord la dessus. C’est à toi de prouver que la définition du “temps redressé” ne fait pas déjà consensus, et qu’il y aurait d’autres définitions possibles, plus pratiques, etc. Je n’en connais aucune de plus pratique, après étudier la question à fond. Le temps blockchain est une information technique qui fait consensus, l’heure redressée aussi, dans la mesure où elle est déterminée à partir d’une simple constante liée à la monnaie.
`userTime = medianTime + `. Je ne vois pas l’interet de forcer tous les clients à refaire le même calcul. Sauf si , encore une fois, tu as mieux mais alors montre nous ton calcul.
Je rajoute enfin qu’on peut rendre ce champs explicite, par son nommage. par exemple `effectiveTime`, `straightenedTime` ou `userTime`.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/68):
>
> Cela dépend des utilisateurs finaux de chaque clients. Ce n’est pas aux serveurs blockchain d’'en décider.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/68):
>
> La formule de transformation du temps blockchain commun utilisée par Cesium ne me parle pas et n’est pour moi qu’une interprétation de se temps blockchain commun parmi d’autres.
Ce temps redressé est parfaitement défini et compris par la plupart des acteurs. Galuel et cgeek compris, avec qui je nous l’avons défini. La formule est quand même assez triviale.
Je ne vais pas attendre patiemment que tu la comprennes.
> [@Questions GraphQL et la RFC pour l'APi GVA](https://forum.duniter.org/t/questions-graphql-et-la-rfc-pour-lapi-gva/5701/68):
>
> Cependant il faut que j’en comprenne le besoin et la pertinence
Non, il ne ‘faut’ pas, justement. En revanche je peux comprendre que tu “ai envie”. Mais c’est tout à fait différent. A ce stade, je me passe volontier de ta permission.
Je vois bien que nous ne sommes pas sur la même longueur d’onde, et je ne vais attendre que tu comprennes tout pour avancer. Si mes choix ne sont pas bons, tu auras donc l’occasion de les critiquer a posteriori, et non pas l’inverse.
Je vais spécifier et coder, et avancer avec du concret, et non pas discuter pendant des heures avec toi.
De toute manière, il n’y a pas encore de noeud DURS en exploitation, si ? Et vous n’avez pas commencé à codé GVA, si ?
---
### Author:  [@elois](https://forum.duniter.org/u/elois)
#### Post date: [29 July 2019 19:08 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/6 "2019-07-29T19:08:35Z")
> [@kimamila](#):
>
> le montant du mouvement (et non pas le montant de la transaction, car une transactions peut concerné plusieurs comptes destination")
En effet dans ce cas ce n’est pas un tableau de transactions qu’il faut retourner mais un tableau de Movements (nouveau type a définir dans le schéma).
> [@kimamila](#):
>
> Oui, tout à fait. En revanche je ne trouve pas le nom du paramètre “account” très intuitif… a voir.
> Peut-être plutôt :
Ok peut t’on partir plutot sur address pour les clés publiques simploe et scriptConditions pour les script ?
En effet, on avait parlé de passer a un système d’adresses a terme dans le protocole, pubkey sera donc obsolète a terme, ça peut être bien d’en tenir compte dés maintenant et d’utiliser le terme address et précisant en commentaire que pour le moment c’est un pubkey.
> [@kimamila](#):
>
> C’est à toi de prouver que la définition du “temps redressé” ne fait pas déjà consensus, et qu’il y aurait d’autres définitions possibles, plus pratiques, etc.
Je n’ai rien a prouver. Je te propose un compromis avec 2 champs pooiur le temps :
blockchainTime:
estimatedUserTime:
Je comprend tout a fait cette formule et me souviens très bien de qui l’a proposée et pourquoi. Je sais donc aussi que ce n’est qu’une estimation qui n’est valable que sous l’hypothèse d’une excellente régularité des blocs, ce qui n’est pas le cas en pratique. Il y a sans doute d’autres moyens d’estimer le temps réel et ce basant sur d’autres hypothèses plus complexes mais plus souvent vraies.
Je dit juste qu’il n’y a aucun sorte de raison pour que ce temps soit le temps de référence.
Avoir 2 champs time dont l’un est explicitement marqué comme n’étant pas le temps de référence mais un temps estimé/calculé/rectifié pour l’utilisateur final peut a la limite me convenir 🙂
> [@kimamila](#):
>
> Je vois bien que nous ne sommes pas sur la même longueur d’onde, et je ne vais attendre que tu comprennes tout pour avancer. Si mes choix ne sont pas bons, tu auras donc l’occasion de les critiquer a posteriori, et non pas l’inverse.
> Je vais spécifier et coder, et avancer avec du concret, et non pas discuter pendant des heures avec toi.
Dans ce cas GVA prend un très mauvais chemin et ne sera pas bien mieux que BMA.
Le but n’est pas de passer d’une API toute pensée par les dev server a une API toute pensée par les dev client mais de réfléchir ensemble pour concevoir la meilleure API possible, qui réponde a la fois a certains besoins des clients tout en préservant autant que possible les besoins de scalabilité coté serveur.
Je trouve très impoli de ta part de vouloir imposer ainsi tes choix sans vouloir discuter. Tu me force la main et cela va impacter le développement de Durs (car nous seront bien obligé d’être compatibles avec Cesium de toute façon).
Je te propose d’en discuter et d’être a l’écoute de tes besoins, que demande tu de plus ?!?
Passer en force seul est un jeu dangereux.
Je te prie de bien vouloir travailler en équipe, pour le bien de la G1 🙂
Fait une MR et on en discute.
---
### Author:  [@Moul](https://forum.duniter.org/u/Moul)
#### Post date: [29 July 2019 20:13 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/7 "2019-07-29T20:13:19Z")
La question est de savoir qui du client ou du nœud doit faire le calcul, par exemple, du solde des comptes ou d’autres calculs couteux.
Ça a un inconvénient du côté nœud car ça ajoute une complexité et une charge non-nécessaire au fonctionnement de la blockchain. Le fait que cette API soit modulaire résouds ce problème.
Côté client, ça fait une charge de travail en moins, ce qui permet d’avoir un client rapide sur une machine de faible puissance. Par contre, ça la déplace la charge CPU et algorithmique côté nœud.
Personnellement, je ne sais pas ce qui est bon de faire.
---
### Author:  [@kimamila](https://forum.duniter.org/u/kimamila)
#### Post date: [30 July 2019 07:21 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/8 "2019-07-30T07:21:27Z")
> [@elois](#):
>
> Dans ce cas GVA prend un très mauvais chemin et ne sera pas bien mieux que BMA.
> Le but n’est pas de passer d’une API toute pensée par les dev server a une API toute pensée par les dev client mais de réfléchir ensemble pour concevoir la meilleure API possible, qui réponde a la fois a certains besoins des clients tout en préservant autant que possible les besoins de scalabilité coté serveur.
> Je trouve très impoli de ta part de vouloir imposer ainsi tes choix sans vouloir discuter. Tu me force la main et cela va impacter le développement de Durs (car nous seront bien obligé d’être compatibles avec Cesium de toute façon).
Tu fais erreur, je n’ai pas dis que je voulais travailler seul. J’ai simplement dit que je me passe de ton approbation. Tu n’es pas équivalent à “les dev”. Ne m’en veut pas, mais je ne crois pas que tu ai suffisamment d’expérience en développement, de mon point de vue, sur ces sujets précis d’API cliente.
La, je te dis les choses franchement, car ca me fatigue déjà de t’entendre dire “c’est dangereux pour la G1… il faut que … etc.” sans élément concret dernière. Je préfères couper court, histoire de ne pas m’énerver contre toi (“mieux vaut prévenir que guérir”, non ?).
Je n’ai aucun animosité, ni rien (tu me connais !). Juste pas envie de parler des heures sur une API **qui n’est encore implémenté nulle part**.
Il te suffit de comprendre qu’en codant je vais défricher les choses. Puis je mettrai à jour la RFC, puis on commencera les itérations/discussions. Je vais pas faire une MR à chaque petite modif, quand même !?
En revanche, toi tu pourra en faire, ensuite, pour critiquer : mais au moins on sera sur du concret, et si tu dis "attention c’est dangereux (niveau perf, etc.) tu pourras le vérifier sur l’implémentation réalisée.
Comme déjà évoqué maintes fois, tout spécifier à l’avance sans mise à l’épreuve régulière n’est pas l’approche suffisamment opérationnelle **selon moi**. C’est sur ce point que nous ne sommes pas d’accord. Dis-toi s’il te plait que c’est mon implémentation sera juste une preuve de concept, qu’on pourra retravailler ensuite ensemble.
Je t’invite donc, a ne surtout pas implémenter GVA pour le moment, sur RUST.
Et tu fera toutes les MR que tu veux sur la RFC, quand elle sera stabilisée de mon côté.
---
### Author:  [@kimamila](https://forum.duniter.org/u/kimamila)
#### Post date: [30 July 2019 07:26 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/9 "2019-07-30T07:26:28Z")
> [@Moul](#):
>
> La question est de savoir qui du client ou du nœud doit faire le calcul, par exemple, du solde des comptes ou d’autres calculs couteux.
> Ça a un inconvénient du côté nœud car ça ajoute une complexité et une charge non-nécessaire au fonctionnement de la blockchain. Le fait que cette API soit modulaire résouds ce problème.
> Côté client, ça fait une charge de travail en moins, ce qui permet d’avoir un client rapide sur une machine de faible puissance. Par contre, ça la déplace la charge CPU et algorithmique côté nœud.
>
> Personnellement, je ne sais pas ce qui est bon de faire.
Les calculs que je propose coté noeud ne sont pas nécessairement couteux. Mais pour le vérifier, il faut débuter une implémentation. Sinon, on parle dans le vide.
Je développe des applications serveur depuis 15 ans. A chaque fois, je met en place des systèmes de cache, qui permettent de décharger beaucoup les accès coûteux. Typiquement, pour éviter les accès BDD. On peut même ensuite imaginer des réglages sur le front (nginx, etc.) pour optimiser le tout.
Bref, pour le moment, il n’y pas lieu de s’inquiéter.
Pour le calcul du montant d’un mouvement, on parle juste d’une itération (et une seule) sur les inputs/outputs d’un TX, sachant que (pour Duniter) on les a déjà en mémoire. Par ailleurs, ensuite on gagne du temps en évitant la sérialisation complète de ces tableaux, dans la réponse JSON. L’un dans l’autre, à mon avis, c’est idem.
---
### Author:  [@vit](https://forum.duniter.org/u/vit)
#### Post date: [30 July 2019 10:31 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/10 "2019-07-30T10:31:00Z")
En tant que développeur client, GVA a été demandée et voulue pour répondre aux problématiques des clients, je dirais, un peu pour taquiner, quoi qu’il en coûte côté serveur. Elle est ajoutée sous la forme d’une extension optionnelle au serveur, justement parce qu’elle va solliciter les ressources de celui-ci.
Donc on peut se lâcher. Les développeurs clients dont je fais partie rongent leurs freins et attendent tous une vraie API pour client depuis longtemps (cf. les souffrances et lenteurs de BMA subies par les dev client Kimamila, Inso, Moul, etc). L’arrivée de WS2P nous permet de faire de GVA ce dont on rêve depuis le début.
GVA doit donc être un développement _client-driven_ répondant aux demandes des clients, sinon autant laisser tomber cette API et en créer encore une nouvelle ARFC (API REALLY FOR CLIENT). 😉
---
### Author:  [@kimamila](https://forum.duniter.org/u/kimamila)
#### Post date: [4 August 2019 13:34 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/11 "2019-08-04T13:34:34Z")
Tiens, autre exemple des complications d’avoir les TX au format brut : [Rémunération des contributeurs au projet Duniter](https://forum.duniter.org/t/remuneration-des-contributeurs-au-projet-duniter/4995/47)
La gestion des TX multi- destinataires, et leur affichage dans les clients
---
### Author:  [@elois](https://forum.duniter.org/u/elois)
#### Post date: [5 December 2019 15:43 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/12 "2019-12-05T15:43:09Z")
Concernant les noms de champs, je me disais que faire une nouvelle API c’est l’ocassion de donner enfin un nom plus logique a certains champs, le champ medianTime du bloc porte ce nom pour des raisons historiques liés au fait que les anciennes versions du protocole se basaient sur le temps médian des X derniers blocs pour calculer le temps blockchain. Désormais le protocole se base sur la moyenne, mais ça pourrait encore changer a l’avenir.
Fonctionnellement il y a deux temps :
1. Le temps blockchain commun, celui qui fait foi pour l’application des évenements temporels (création du DU, expirations, etc)
2. Le temps blockchain « redressé », celui qui est obtenu par calcul a partir du temps blockchain commun dans le seul but d’afficher un temps a l’utilisateur final.
Il me semblerais plus logique de nommer le 1er `commonTime` ou `blockchainTime` , et le 2ème `humanTime` ou `adjustedTime` , qu’en pensez vous ?
---
### Author:  [@elois](https://forum.duniter.org/u/elois)
#### Post date: [5 December 2019 16:38 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/13 "2019-12-05T16:38:50Z")
Réponse complète de kimamila :
> [@On another topic](https://forum.duniter.org/t/6613/22):
>
> Je penses qu’il faut resté cohérent avec les documents du protocole. Sinon, on y comprendra plus rien.
> Pour moi, il faut garder `medianTime` car au moins on sait d’où vient l’info.
> Ou alors, quitte à être précis, renommons en `averageTime` .
>
> On peux aussi mettre les deux : `medianTime` et son alias. Ca me parait pas déconnant.
* * *
Ma réponse :
> [@On another topic](https://forum.duniter.org/t/6613/22):
>
> Je penses qu’il faut resté cohérent avec les documents du protocole. Sinon, on y comprendra plus rien.
Je pense l’inverse au contraire. Certains champs du protocole ont un nom qui mériterait justement une mise a jours, et je compte bien proposer un changement de certains nom dans le protocole le moment venu, notamment `medianTime` m’a toujours dérangé.
Avec la conception de la nouvelle API Client, c’est maintenant ou jamais que l’on peut choisir des noms clair et simple qui désignent bien ce qu’ils désignent et qui faciliteront la compréhension des futurs contributeur.ices.
C’est maintenant que c’est le plus facile, si on ne se pose pas ces questions de nommage maintenant, on ne le fera jamais 😉
Je pense qu’il est préférable de choisir des nom orienté métier et pas technique, le développeur lambda qui débarque et souhaite utiliser l’API, en 1ère approche il s’en fou de savoir si c’est un temps calculé par une moyenne, une médiane ou tout autre chose. Ce qui l’importe c’est qu’il y a un temps commun(ou temps blockchain), que c’est lui qui fait foi; et qu’il ne correspond pas au temps “réel” d’où le “adjustedTime”.
De plus, si votre code utilise un nom de champ différent parce qu’il vous “parle plus”, pas besoin de refactorer votre code, il vous suffit de déclarer un alias dans votre requête graphql :
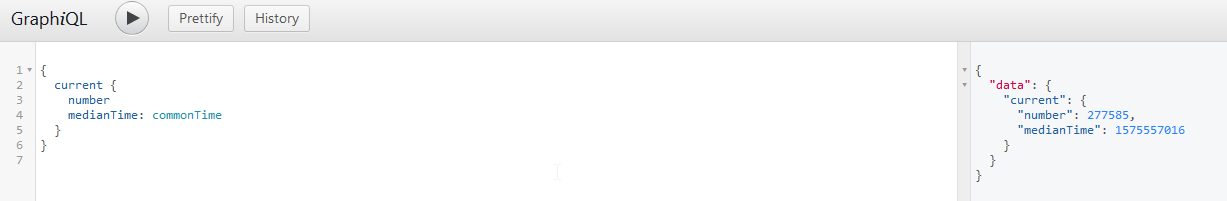
Ainsi, chacun peut recevoir les champs sous le nom qui lui semble logique. Et le nom officiel de l’API peut rester centrer sur l’objectif d’'être un nom pertinent d’un point de vue métier 🙂
> [@On another topic](https://forum.duniter.org/t/6613/22):
>
> Ou alors, quitte à être précis, renommons en `averageTime` .
L’inconvénient d’un nom technique c’est qu’il n’est plus pertinent dés que la formule derrière change, donc `averageTime` ne me conviens pas non plus. C’est pertinent maintenant, mais le jours ou la méthode de calcul du temps blockchain change pour une quelconque ğraison alors le nom de ce champ sera de nouveau non-pertinent pour des raisons historiques.
En nommant les champs selon les concepts métier, on restera agnostique de l’implémentation technique. Ce qui permettra de garder un nom pertinent bien plus longtemps, et de simplifier la compréhension des futurs arrivants 🙂
---
### Author:  [@vit](https://forum.duniter.org/u/vit)
#### Post date: [5 December 2019 18:07 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/14 "2019-12-05T18:07:48Z")
Je suis d’accord et je propose :
- **blockchainTime** : temps de la blockchain.
- **humanTime** ou **displayTime** : le temps affiché pour les humains. (_ajustedTime_ décrit ce qui se passe pour l’obtenir et on s’en fout comme tu le dis) 😉
---
### Author:  [@elois](https://forum.duniter.org/u/elois)
#### Post date: [5 December 2019 21:43 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/15 "2019-12-05T21:43:09Z")
> [@vit](#):
>
> - **blockchainTime** : temps de la blockchain.
> - **humanTime** ou **displayTime** : le temps affiché pour les humains. ( _ajustedTime_ décrit ce qui se passe pour l’obtenir et on s’en fout comme tu le dis)
Ok pour `blockchainTime` et `humanTime`. Est ce que c’est ok pour toi @kimamila ?
---
### Author:  [@cgeek](https://forum.duniter.org/u/cgeek)
#### Post date: [8 December 2019 11:47 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/16 "2019-12-08T11:47:33Z")
> [@vit](#):
>
> En tant que développeur client, GVA a été demandée et voulue pour répondre aux problématiques des clients, je dirais, un peu pour taquiner, quoi qu’il en coûte côté serveur.
Il faudrait confirmation d’@elois, mais il me semble que sa position a changé, qu’il désormais d’accord avec cette approche et que l’API GVA au sein de Dunitrust reposera sur une architecture telle qu’on puisse partir du principe que GVA est neutre vis-à-vis du nœud sur lequel elle repose.
Pour ma part, c’est clairement le chemin pris : si une API GVA voit le jour sur Duniter, ce sera un logiciel à part, avec sa propre base de données, lourde. Je pense exploiter cette base de données pour accélérer prochainement l’API BMA du nœud [g1.duniter.org](http://g1.duniter.org).
---
### Author:  [@elois](https://forum.duniter.org/u/elois)
#### Post date: [8 December 2019 15:19 UTC](https://forum.duniter.org/t/rfc-gva-movementsbypubkey-et-time-redresse/6344/17 "2019-12-08T15:19:34Z")
> [@cgeek](#):
>
> Il faudrait confirmation d’@elois, mais il me semble que sa position a changé, qu’il désormais d’accord avec cette approche et que l’API GVA au sein de Dunitrust reposera sur une architecture telle qu’on puisse partir du principe que GVA est neutre vis-à-vis du nœud sur lequel elle repose.
En effet, il y aura finalement deux livrables différents pour dunitrust-server :
1. Un livrable `dunitrust-member-server` qui sera minimaliste mais complet (WS2P public et privé, forgeage des blocs, etc), mais qui sera dépourvu d’api GVA, et donc les prérequis matériels seront minimaux (notamment compatible rasberry pi et autre micro-pc).
2. Un livrable `dunitrust-mirror-server` qui comportera l’api GVA mais qui sera plus gourmand en ressources (prérequis matérielles différents), ce dernier ne sera pas fourni pour arm et ne sera pas en mesure de calculer des blocs\*, ce qui permetra de l’installer sans problème sur un serveur dédié.
\*Comme je l’ai indiqué lors de ma présentation aux RML14, je souhaite que les noeuds membres soient le moins exposés possibles (donc sans API client), pour limiter au maximum la surface d’attaque sur les noeuds membres, car ces dernier sont les plus sensibles.